2014年4月9日 星期三

Setup git server

以前在使用git的時候都是同事幫忙架設,這次剛好有機會順便紀錄一下

Git Server

1. 安裝必要套件

#  apt-get install git-core

2. 建立repository

假設所有的project都欲放置/opt/git 並且建立名為project1的git
a. # mkdir /opt/git
b. # mkdir /opt/git/project1
    # cd /opt/git/project1
    # git --bare init


Git Client

在使用者端,假設project的位置是~/projectA
# mkdir ~/projectA
# cd ~/projectA
# git init
# echo "project init">>init
# git add .
# git commit -m "init project"
# git remote add origin user@[IP]:/opt/git/project1
# git push origin master

2014年4月8日 星期二

iSCSI Target and Initiator

iSCSI Target是Server端,提供iSCSI 空間。
iSCSI Initiator是Client端,連接既有的iSCSI空間來使用。

iSCSI Target

在Ubuntu上安裝

1. 選擇要提供空間的裝置

提供服務的空間可以是一個硬碟、一個partition、一個LVM的LV或是使用DD產生一個空間。
使用以下的方法可以在/media下產生一個20G名稱為volume0的空間。

#  dd if=/dev/zero of=/media/volume0 count=0 obs=1 seek=20G

2. 安裝必要套件

使用APT來安裝必要套件

# apt-get install  iscsitarget iscsitarget-dkms

3. 設定iSCSI 

a. 設定開機自動啟動
Edit /etc/default/iscsitarget

change 
ISCSITARGET_ENABLE=false
to 
ISCSITARGET_ENABLE=true

b. 設定iSCSI Target
Edit /etc/iet/ietd.conf

加入
Target iqn.2010-12.nl.ytec.arbiter:arbiter.blabla.lun1
Lun 0 Path=/media/volume0,Type=fileio,ScsiId=lun0,ScsiSN=lun0

其中,需要修改的參數是:
I. Target 後面接的名字,可自訂。
II. Lun一定要從0開始。
III. PATH後面接的參數是空間的位置,如果是剛剛使用dd 產生出來的則為/media/volume0否則更改為實際的空間例如/dev/sdb1 etc.

4. 重新啟動iSCSI Target

# /etc/init.d/iscsitarget restart


iSCSI Initiator

以OpenSuse為例

1. 安裝必要套件

# yast -i open-iscsi

2. 搜尋可用iSCSI Lun

使用iscsiadm來搜尋可用的裝置
# iscsiadm -m discovery --type=st --portal=[iscsi target的IP]

sample output:
192.168.1.101:3260,1 iqn.2010-12.nl.ytec.arbiter:arbiter.blabla.lun1

3. 連接裝置

確定找的到裝置之後就可以連接iSCSI裝置
# iscsiadm  -m  node  -T iqn.2010-12.nl.ytec.arbiter:arbiter.blabla.lun1 --login

使用lsscsi來檢查是否有連接成功
# lsscsi

Sample output:
[0:2:0:0]    disk    Intel    MegaSR           1.0   /dev/sda
[1:2:0:0]    disk    Intel    RMS25CB080       3.22  /dev/sdb
[18:0:0:0]   disk    IET      VIRTUAL-DISK     0     /dev/sdc

4. 掛載裝置

假設我們欲將裝置format成XFS並掛載到/opt/iscsi

# mkfs.xfs /dev/sdc
# mkdir /opt/iscsi
# mount -t xfs /dev/sdc /opt/iscsi

2014年4月4日 星期五

大資料資料庫儲存-NoSQL比較及效能差異(VII)

在大資料資料庫儲存的最終篇將比較各NoSQL的差異和效能的比較。

NoSQL 比較

Experiment Environment

Hardware and Network Topology


Software Version


MySQL VS Big Data


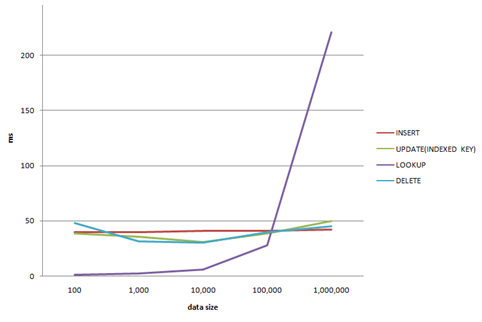
 Insert Data


 Update Data

Look-up Data

Delete Data


大資料資料庫儲存-Memcache和Redis介紹(VI)

Memcahce和Redis都是大多數被拿來當Cache system用途的NoSQL。他們的共通點是都是以Key-Value的形式將資料存在記憶體中。因此R/W的IO非常的快。

而兩個比較大的差別是,Redis可以將資料儲存在Local Drive中,而Memcache只能存在memory。另外一點則是,Memcache的value沒有型別而Redis則支援多種型別ex. map, set, list etc.

Memcahce

Memcache Use Scenario


REDIS


REDIS Data Type


大資料資料庫儲存--MongoDB介紹(V)

前一篇介紹了HBase,接著將繼續介紹MongoDB

MongoDB

MongoDB是由10gen這一家公司開發的,與Cassandra和Hbase不同的是,MongoDB是一個document base的一個NoSQL。他支援Auto-sharding的功能另外一個比較特別的是,它內建了以javascript來利用map-reduce的概念搜尋資料。

Data Structure

MongoDB既然說是一個Document base的資料庫,那麼舉個最簡單應用的例子來說明他的優點。假設我們有一個database是紀錄post文章和每個文章的comment。以RDBMS最簡單的方式就是建立兩個table分別存放文章和comment。因此要撈出某一筆文章和其留言就必須要兩個query。

那麼MongoDB呢?既然他是Document base,那麼我們可以在一個document記錄了文章和留言,因此,撈出一篇文章和留言就只需要一個request!

Write Path

MongoDB有三個角色,分別是存放Data的mongod、Cmongod存放shard key和mongos負責做load balance和將使用者的request導到對的shard server。

 When to use MongoDB?

MongoDB可以非常lightweight(有人想要取代sqlite),當你沒有複雜的transaction ex. 不是banking的系統就可以看看MongoDB。

大資料資料庫儲存--HBASE介紹(IV)

前一篇介紹了Cassandra,而在這裡將繼續介紹Cassandra。

HBase

Hbase是一個Apache top-level的project。他強調的是CAP理論中的CP也就是consistency 和Partition tolerance。

HBase Data Model

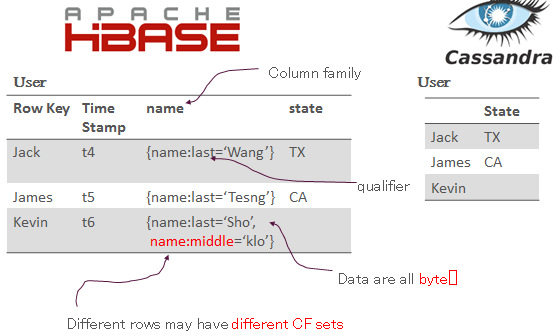
既然前一篇介紹了Cassandra,那麼在這裡就以Cassandra的範例來比較Hbase和Cassandra的不同。

Hbase最大的不同是,他的每一個CF(Column family)即為一個map,而每一筆資料的CF的ket set可以是不同的。而另外一點是,在hbase裡,所有的data都為byte array。

HBase Data Path 

Hbase有一張很嚇人的圖,它的特點是箭頭特別多。但是我們可以很簡單的理解這張圖

 以下圖為例,Hadoop的Data node其實就是很多台可以存放data 的node。以上圖為例,負責回應request的Hbase 節點有兩個。
P.S. Hbase是可以把資料存放在local disk而非HDFS不可的。
 使用者(client)會先留到zookeeper,zookeper會將使用者導到其中一台hbase server。使用者Insert依資料時,hbase會先存成hlog(在損毀時可以roll back)然後存到memstore(可以想像成memory 的小database)接著把資料存到HDFS中稱作Hfile。

NoSQL DON'Ts

在NoSQL風靡了幾年之後,開始有人反思:到底NoSQL真的有比傳統的RDBMS好嗎?或者說,我們真的需要NoSQL嗎?

在選擇之前,必須要先了解NoSQL 做不到的事:
另外一個迷思是,很多人認為在大資料的時代下,傳統的RDBMS是無法應付的?真的是如此嗎? 以Facebook為例,他們是使用sharding來存放使用者的post。你的資料有比他多嗎?

大資料資料庫儲存--Cassandra 介紹(III)

上一篇 我們介紹了什麼是NoSQL,在這裡,我們即將慢慢地介紹常見的NoSQL。

Cassandra

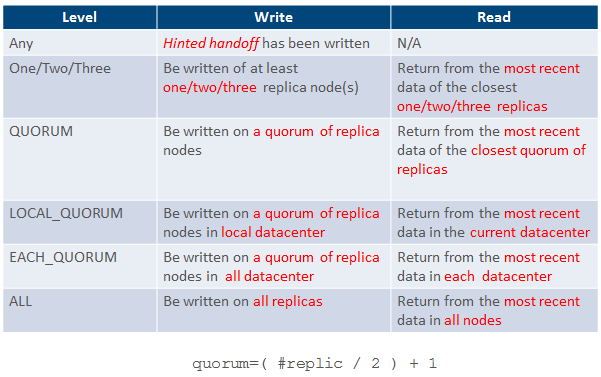
Cassandra是Apache Software foundation的top-level project。他是key-value的結構,比較不一樣的是它是tunable的consistency。什麼意思呢?就是說他可以選擇consistency的程度,例如確保2個data node的資料都被更新了才return 成功或是全部都更新了才回傳成功。

Cassandra Data Model

Cassandra的Data model主要有Keyspace對應RDBMS的database、Column family對應Table、Row key對應Primary key和Column name/key對應Column name。

我們可以簡單地把Keyspace裡面的column family(RDBMS的Table)看成是一個map of a sorted map。一個column family是一個sorted map,他的key就是每個row的row key,而value是一個map,存放每一個column 的value e.g. map<column name, column value>。
Cassandra的Column family有兩種分別是Static column Family和Dynamic column family。Static column Family和RDBMS很像,在create column family(table)的時候就定義好schema。而Dynamic column family則是在Insert data的時候,data的你仍舊可以插入未定義的column。舉例來說,假設我們的schema定義了name, email, address,你仍舊可以插入一個叫state的column的data。

另外一個不一樣的是,在RDBMS插入一個空的內容仍舊會佔去空間的。舉例來說,假設插入了一筆資料,其中一個定義4 byte char的欄位是空的,仍舊會佔去4 byte。Cassandra則沒有這個問題。

Cassandra write path

Cassandra Tunable Consistency

Cassandra分了6個consistency level如下表: